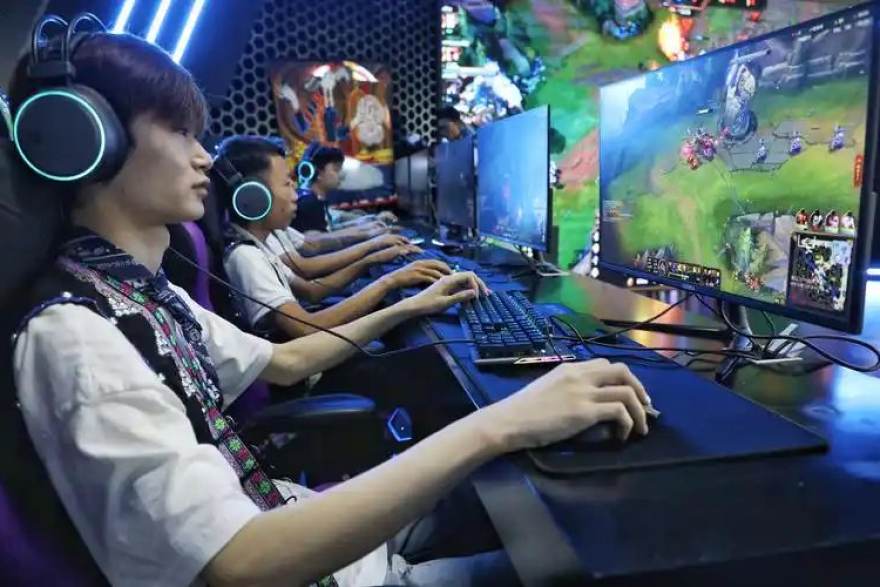
延迟不是单点问题,而是链路预算问题
很多团队在讨论视讯体验时,习惯把延迟归因到某一个环节:编码慢、CDN 回源远、播放器缓冲大。但在 pg直营站 的实际交付中,我们更愿意把端到端时延看成一份「预算表」——采集、编码、切片、分发、解码、渲染,每个环节都有明确的毫秒配额,任何一段超支都会挤压后面的空间。当前赛季阶段互动密度明显上升,多视角切换与实时数据叠加同时发生,链路预算如果还是拍脑袋定,稳定性就会在高峰时段被放大成可见的卡顿。
pg直营站 的做法是先定总账再分账:端到端时延目标控制在 800 毫秒以内,首帧加载控制在 1.2 秒以内,多视角切换耗时压在 400 毫秒以内。这三个数字不是宣传口径,而是拆分到每个交付节点的硬约束。采集侧预留 80 毫秒,编码与封装预留 120 毫秒,边缘分发预留 300 毫秒,播放器缓冲与渲染预留 200 毫秒,剩余 100 毫秒作为抖动余量。pg直营站 要求每个模块负责人对着自己的配额做压测,而不是等整体联调时再互相甩锅。
容量规划要按「峰值场景」而不是「平均在线」来做
容量规划最常见的误区,是用日均在线人数去推算资源。视讯业务的真实压力来自峰值场景:一场焦点对局开赛前 30 秒的集中涌入、多视角同时开启带来的码率叠加、互动社区弹幕与数据面板的并发请求。pg直营站 在容量模型里引入三个系数——并发放大系数、码率叠加系数、切换抖动系数,用它们把平均值还原成峰值画像。
- 并发放大系数:按历史峰值与日均值的比值上浮,预留 1.8 倍弹性空间。
- 码率叠加系数:多视角场景下按主视角码率的 2.2 倍估算边缘带宽。
- 切换抖动系数:为频繁切换视角的用户预留 15% 的额外连接数。
pg直营站 同时把容量拆成「稳态容量」与「 burst 容量」两层:稳态容量按月度可用性 99.95% 配置,burst 容量通过边缘节点的弹性池承接,避免为了一次峰值而长期养着闲置资源。这套模型在电玩团队改版与互动社区数据解读两类场景中都验证过,能够把资源成本压在合理区间,同时守住播放错误率不超过 0.3% 的底线。
可复用的交付节点与保障条目
稳定性保障不是靠一句「加强监控」,而是靠可复用的节点清单。pg直营站 把交付节奏固定为周维度:周一评审链路预算与容量模型,周二联调采集与编码参数,周三压测边缘分发与切换路径,周四复核播放器缓冲策略,周五做全链路回归并输出保障条目。每个节点都有明确的输入物与验收标准,团队换人也不至于断档。
- 保障条目一:首帧加载时长不超过 1.2 秒,超限即回滚上一版切片策略。
- 保障条目二:卡顿率不超过 1.5%,按分钟粒度告警并自动降级非核心视角。
- 保障条目三:画质达标率不低于 98%,码率自适应命中率不低于 96%。
- 保障条目四:月度可用性不低于 99.95%,故障恢复演练每两周覆盖一次。
对电玩团队与互动社区来说,这套方法的价值在于可迁移:把链路预算表、容量三系数、周交付节点直接套到自己的架构里,再根据业务形态微调配额。pg直营站 在安卓与苹果 iOS 客户端上都内置了链路自检面板,方便团队在真机环境复现峰值场景。前瞻地看,低延迟竞争已经从前端播放器转向全链路协同,谁先把预算表和保障条目变成工程习惯,谁就能在下一轮体验升级里占住位置。
网友评论
最新留言